用 AI 会让人「降智」吗?6 条说法 × 21 篇文献逐一核验
一句话结论:无护栏的 AI 依赖确实损害学习(撤走后 −17%);加护栏后负效应几乎归零。「AI 提效」高度依赖任务边界——资深开发者在成熟代码库实测反而慢 19%。
- 证据最硬的一条:「无护栏的 AI 依赖确实损害学习」——随机对照田野实验(PNAS,约 1000 名高中生):用 AI 时成绩 +48%,撤走 AI 后反比从未用过的学生低 17%。
- 「降智」不是宿命,是设计问题:同一批研究里,加了「只提示、不代做」学习护栏的 AI 导师几乎消除了负效应;设计得当的 AI 导师组用更少时间学到更多(RCT)。
- 「AI 提效」也不保证成立:METR 随机对照实验中,资深开发者自评快 20%,实测慢 19%——「感觉」和「实测」会背离;但客服场景 5179 人实测 +14%,新手受益最大。任务边界决定方向。
- 证据强度分层明显:RCT(因果)> 大样本调查(相关)> EEG 预印本(待复现)> 哲学论证。「认知债」等被热议的结论多数还在第一梯队的下游。
- 对组织的可操作结论只有三条:设计护栏、保留必须自己判断的环节、用客观指标而非主观感受评估收益。
1 · 把情绪文拆成 6 条可检验命题
被核验的原文本是 Alexandru Nedelcu 的评论文章《AI Has No Wisdom and Neither Will You》(alexn.org,2026-09-22)。它是观点文,不是研究——但观点里藏着可以拿证据检验的经验主张。我把它拆成 6 条:
| # | 文章论断 | 可检验形式 | 文献裁决 |
|---|---|---|---|
| C1 | AI 没有「智慧」,只有模仿 | AI 能力是否存在「目的反思」层面的上限 | 基本支持(哲学侧);工程侧有争议 |
| C2 | AI 学不会写可维护 / 安全的代码 | AI 生成代码的质量与安全性 | 有支持(安全侧证据扎实) |
| C3 | 依赖 AI 的人「永远无法精通」(降智) | 使用 AI 是否损害学习与技能养成 | 部分支持,条件性强 |
| C4 | AI 的效率收益是幻觉 | 客观实测的生产率变化 | 部分支持(方向混杂) |
| C5 | AI 只会让行业整体变糟 | 组织层面的净效应 | 被反例反驳(存在普惠场景) |
| C6 | 未来「NO-AI」会成为竞争优势 | 组织层面因果证据 | 尚无定论(纯预测) |
关键一步是 C1 和 C3 必须分开:原文把「AI 现在不行」(技术命题)和「用 AI 的人会退化」(认知命题)搅在一起,而这两者的证据强度差别巨大。前者主要是哲学论证,后者有一批可复现方向的实证研究——但也恰恰是后者,被转述得最失真。
C1 的文献现场值得单独一提。哲学侧,Wilby(2026,Human Affairs)给出了与原文几乎同构的表述:cleverness(为给定目的找手段)是 AI 的领域,wisdom(反思性地权衡目的本身)目前不是。工程侧则有拉扯:Bubeck 等(2023)的 GPT-4 系列实验主张「通用智能火花」,「wise machines」框架(2024)主张以元认知为路径让机器逐步接近智慧属性,而 Shojaee 等的《Illusion of Thinking》(2025,预印本,受学界质疑)发现超过一定组合复杂度后推理模型准确率崩塌。也就是说:「AI 没有智慧」在概念层面站得住,但把它当作技术定论去推演后果,文献并不背书。
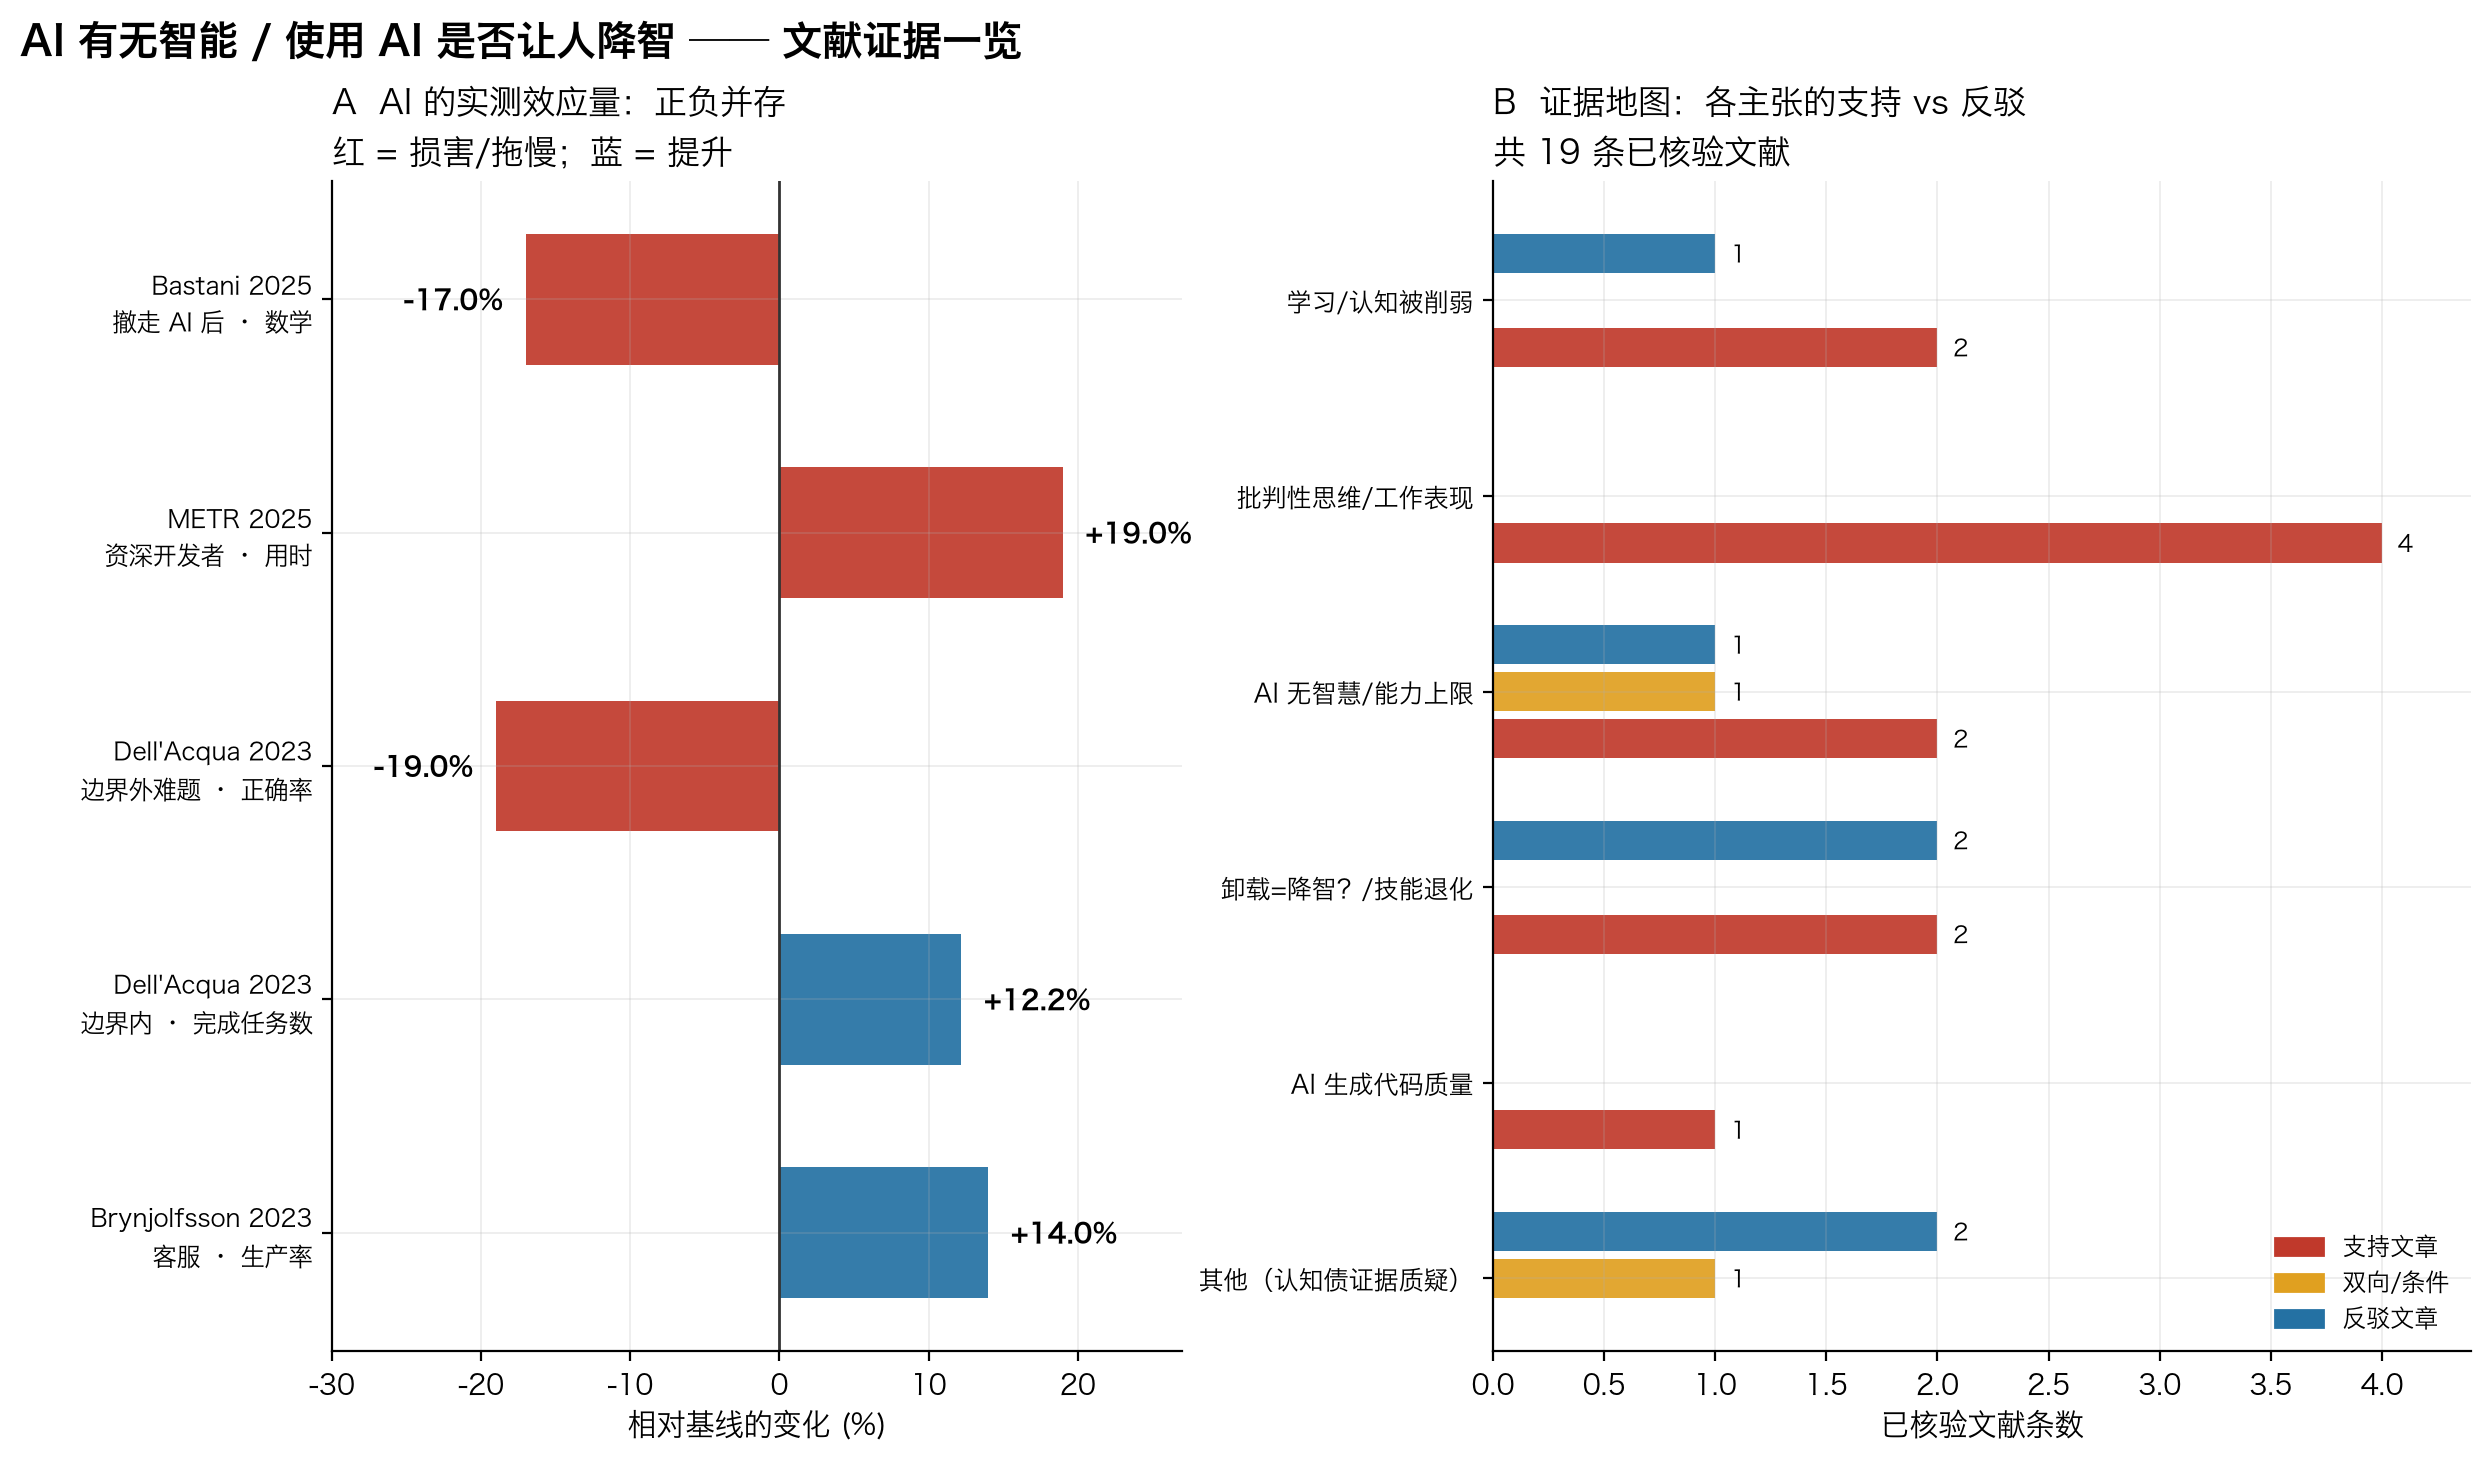
五个标志性实验的实测效应正负并存:受益与受损取决于任务边界与使用方式,而不是「AI 好不好」这个笼统问题。均为经 DOI 核验的公开研究(检索日期 2026-09-24);图 B「19 条」为原调研包按「论断 × 文献」映射的条目口径,与全文 21 篇去重文献总数的差异来自未映射到具体论断的背景与方法学文献。
2 · 无护栏的 AI 依赖确实损害学习(−17%)
这是全文里我最愿意为原文说「你说对了」的部分——前提是把因果链说准确。五项代表性研究:
| 研究 | 设计 | 关键结果 | 证据强度 |
|---|---|---|---|
| Bastani et al. 2025,PNAS | 随机田野实验,约 1000 名高中生(数学) | 用 AI 时成绩 +48%(基础 GPT)/ +127%(带护栏的 GPT Tutor);撤走 AI 后,无护栏组比从未使用者低 17% | 高(RCT、大样本、因果) |
| Gerlich 2025,Societies | 混合方法,666 人问卷 + 访谈 | 频繁使用 AI 与批判性思维显著负相关,由「认知卸载」中介;年轻组依赖更高、得分更低 | 中(相关性,非因果) |
| Lee et al. 2025,CHI(微软研究院) | 调查 319 名知识工作者、936 个实例 | 对 AI 信心越高 → 批判性思维越少;对自身信心越高 → 越多;批判性思维转向「核查与整合」 | 中(大样本,自我报告) |
| Fan et al. 2024,BJET | 随机实验,写作任务 | 提出「元认知懒惰(metacognitive laziness)」:GenAI 组动机与自我调节过程被削弱 | 中(实验证据,单一任务场景) |
| Kosmyna et al. 2025,MIT Media Lab | EEG 对照实验,54 人 | 纯脑组脑连接最强、LLM 组最弱;提出「认知债(cognitive debt)」 | 低-中(预印本,已有公开方法学质疑,待复现) |
三条必须说清的强度校准:
- Bastani 是全场唯一的大样本随机实验,所以「−17%」是这篇文章里最值钱的一个数字:它不只是相关,而是因果——学生把基础 GPT 当「拐杖」,成绩当场好看,能力没留下。
- Gerlich 的 666 人是相关性研究。「频繁用 AI 与批判性思维负相关」不等于「AI 导致批判性思维下降」——也可能是批判性思维弱的人更依赖 AI。转述成因果,是这类研究被引用时最常见的错误。
- 「认知债」还不是定论。Kosmyna 的 EEG 研究是预印本,54 人中仅 18 人完成第四节,已有多篇公开方法学评论指出其样本量、可复现性、EEG 分析与结果报告问题(如 arXiv:2601.00856)。它可以作为「值得严肃对待的信号」,不能当作「大脑被证实的改变」。
代码场景同样有直接证据:Perry et al. 2023(ACM CCS)的用户实验发现,有 AI 助手的参与者写出显著更不安全的代码,而且更相信自己写的是安全的——能力受损与过度自信同时发生,这比单纯的「变笨」更危险。
更系统层面的证据也在积累:2025 年一篇混合方法综述(AI Review,DOI 10.1007/s10462-025-11352-1)专门梳理了医疗领域「AI 致技能退化」的证据与研究议程;AI & Society 的结构化论证(DOI 10.1007/s00146-025-02686-z)则把责任从「个人意志」重新定位到「敌视能力养成的环境」——如果依赖性环境是制度产物,「降智」就首先是设计问题,其次才是自律问题。这为下一节的「护栏」提供了理论落点。
3 · 但加了护栏,负效应几乎归零
如果只看上面一节,结论确实是「别用」。可文献的另一半讲的是相反的故事,而且同样来自随机实验:
- 护栏几乎消除负效应:还是在 Bastani 的实验里,GPT Tutor 组(AI 只提示、不代做,强制先自己思考)撤走 AI 后相对从未使用者约 0% 差距——同一个模型、同一批学生,有无护栏,一个 −17%、一个 ≈0%。
- 设计得当的 AI 导师是加分项:Kestin et al. 2025(Scientific Reports)的 RCT 中,按学习科学证据设计的 AI 导师组用更少时间学到显著更多,参与度与动机更高。
- 认知卸载也可以是建设性的:Scientific Reports 2025 的一项实证发现,GenAI 使用通过「共享元认知」与认知卸载提升学业成就。
- 框架本身有争议:认知科学家 Andy Clark(Nature Communications 2025)直接反驳「卸载即降智」——人类本来就是靠把计算外包给文字、工具与他人来思考的「延伸心智」动物。问题不在卸载,在卸载之后你还剩下什么。
- 学界主流框架本就是「双刃」论:Nature Human Behaviour(2024)的综述把 GenAI 对人类学习的影响定性为「承诺与挑战并存」,而非单向有益或有害——这与「护栏分水岭」的图景一致。
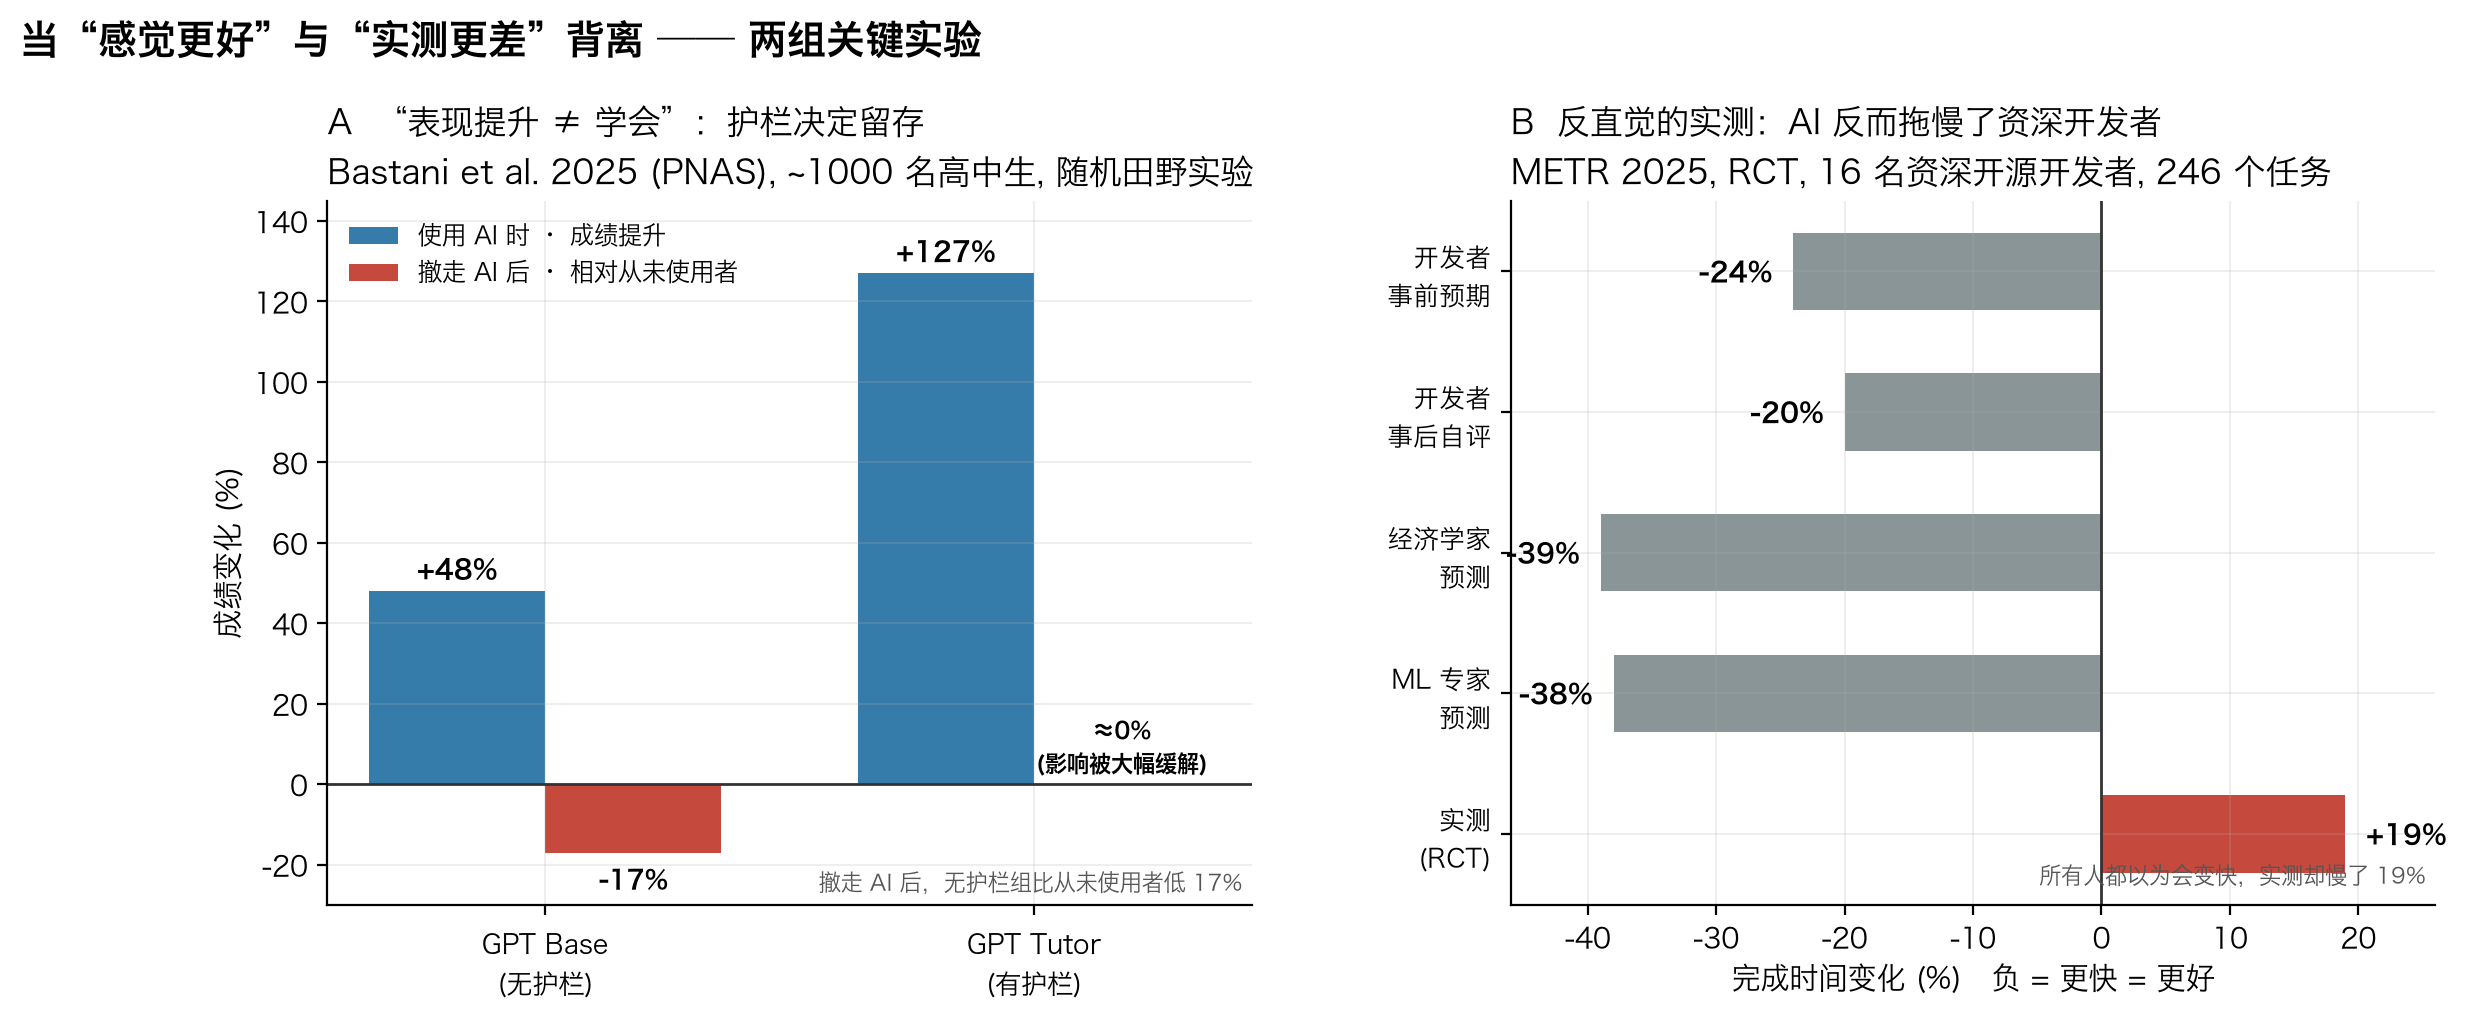
两组关键实验:左——护栏决定学习留存(Bastani,PNAS);右——所有角色都预测 AI 让人更快,实测却慢了 19%(METR)。「感觉更好」与「实测更差」可以同时成立。注意:右图横轴方向为「负 = 更快 = 更好」,实测 +19% 意味着比不使用 AI 慢了 19%。
4 · 效率幻觉:资深者实测慢 19%,新手客服快 14%
原文说「效率收益是幻觉」,这个方向有一项非常反直觉的 RCT 支持,但也仅止于特定边界:
| 研究 | 场景 | 实测结果 | 含义 |
|---|---|---|---|
| METR 2025(RCT,16 名资深开发者、246 个任务) | 平均 5 年经验的成熟开源项目 | 开发者事前预期快 24%、事后自评快 20%;实测用时 +19%(更慢);经济学与 ML 专家预测(快 38-39%)同样全错 | 成熟代码库 + 资深者:AI 可能拖慢,且所有人对自己的感觉都过度自信 |
| Dell'Acqua et al. 2023(BCG,758 名咨询顾问,预注册实验) | 能力边界内任务 vs 边界外难题 | 边界内:多完成 12.2%、快 25.1%、质量更高;边界外:正确率低 19%(「锯齿状边界」) | AI 边界内帮你、边界外害你;难在事前分清自己在边界的哪一侧 |
| Brynjolfsson et al. 2023(NBER,5179 名真实客服) | 呼叫中心引入 AI 助手 | 生产率 +14%,新手与低技能者收益最大,技能差距缩小 | 存在大规模普惠场景——直接反驳「AI 只会让行业变糟」的整体判断 |
把三项放在一起的正确读法不是「谁对谁错」,而是:AI 的净效应是「任务类型 × 使用者经验 × 工作流程设计」的函数。资深者在成熟代码库被拖慢、新手在客服台被提速、咨询顾问在边界内提速在边界外翻车——三条证据互不矛盾,它们在说同一件事:先定位任务在边界的哪一侧,再谈用不用。
边界的代价还不止于个体:Doshi & Hauser(2024,Science Advances)发现 GenAI 让个体创造力提升,却降低了群体层面新内容的多样性——「人人用同一个 AI」的趋同效应,是效率数字之外更隐蔽的账单。
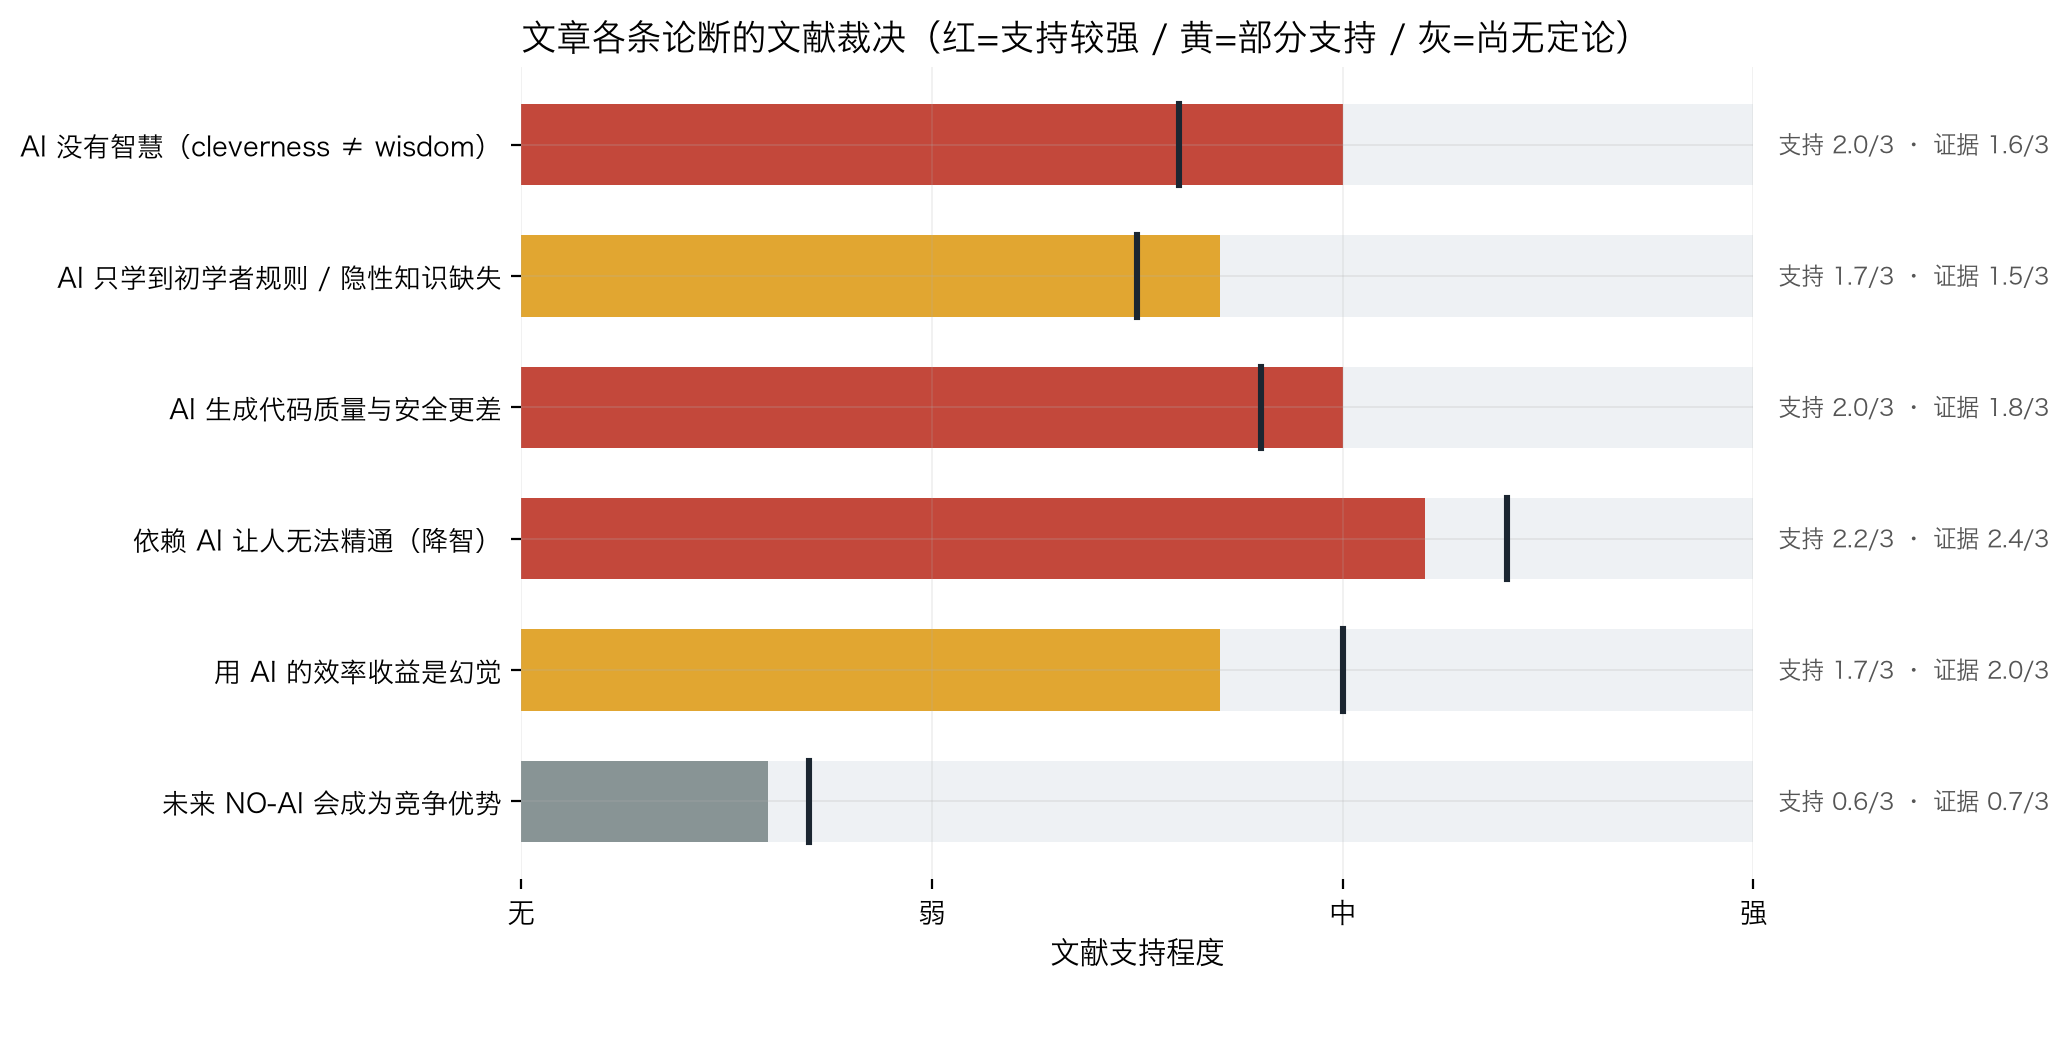
六条论断的文献裁决:「依赖 AI 让人无法精通」是支持最强的一条(且条件是无护栏使用);「NO-AI 竞争优势」尚无任何组织层面因果证据支持。黑竖线为证据强度(研究设计、样本量、可复现性);口径:21 篇经 DOI 核验文献。
5 · 三条可执行的管理动作
21 篇文献核完,真正站得住的结论可以压缩成三句话,恰好对应三个组织动作:
- 把「护栏」写进流程,而不是写进口号。Bastani 的 GPT Tutor 给了可抄的作业:AI 只提示不代做、强制先产出自己的解法、AI 反馈后必须复盘差异。落到团队里就是:AI 产出前先有人的初稿或思路,AI 用后要有差异说明。
- 保留「必须自己判断」的关键环节。Lee 的数据显示批判性思维没有消失,而是迁移到了核查与整合。翻译成岗位职责:AI 可以写,但关键决策的验证、取舍与担责必须有名有姓地落在人头上——尤其是安全、合规、医疗这类高后果场景(Perry 的「更不安全且更自信」就是反例教材)。
- 用客观指标评估 AI 收益,禁用「感觉变快了」。METR 最大的教训是:从开发者自己到经济学专家,所有人对效率的预判全错,且方向一致地乐观。评估 AI 引入与否,只能看实测:周期时间、返工率、缺陷逃逸率这类可以被表计的数字。
这三条合起来的潜台词:「用不用 AI」是个伪决策,「在哪些环节、以什么护栏、按什么指标验收」才是真决策。原文预言的「NO-AI 竞争优势」公司,文献目前既不支持也不反驳——但「无设计地全员用 AI」的组织,已经有一组证据预言了它的样子:边界外翻车、学习被侵蚀、以及一群对效率感觉良好的人。
关键数字速查
| 数字 | 出处(设计·样本) | 场景 | 一句话含义 |
|---|---|---|---|
| −17% | Bastani 2025,PNAS(RCT,n≈1000) | 撤走 AI 后:无护栏组 vs 从未使用者 | 无护栏依赖的学习留存损失 |
| +127% / ≈0% | 同上 | GPT Tutor(有护栏):当堂成绩提升 / 撤走后差距 | 护栏让收益留下、损失归零 |
| +19% 用时 | METR 2025(RCT,16 人 246 任务) | 资深开发者在成熟代码库 | 「感觉快 20%」与「实测慢 19%」并存 |
| +12.2% / −19% | Dell'Acqua 2023(预注册实验,n=758) | AI 能力边界内 / 边界外 | 边界内提速提质,边界外正确率反降 |
| +14% | Brynjolfsson 2023(准实验,n=5179) | 真实客服场景 | 新手收益最大,技能差距缩小 |
FAQ
Q1:这篇文章的结论是不是「别用 AI」?
不是。证据指向的是「怎么用」:无护栏的依赖在实验里造成 −17% 的学习留存损失,而带学习护栏的使用在同一实验里几乎归零损失、甚至正向(+127% 的当堂成绩提升)。禁止使用不会带来护栏的效果,只会丢掉收益。
Q2:「认知债(cognitive debt)」是科学定论吗?
还不是。它来自一项 54 人的 EEG 预印本研究,已完成者更少,且已有多篇公开方法学评论质疑其样本量、分析方法与结果报告。当前合理的态度是「值得严肃对待的信号,等待复现」,不宜写入任何正式制度或宣传。
Q3:666 人的研究不是样本很大吗,为什么说不能证明因果?
样本大解决的是「关系是否存在」,不解决「方向谁是谁的因」。Gerlich(2025)是横断面调查:既可能是 AI 依赖削弱批判性思维,也可能是批判性思维弱的人更依赖 AI,还可能是第三变量。因果结论只能来自像 Bastani、METR、Kestin 那样的随机分配实验。
Q4:METR 的「慢 19%」适用于所有开发场景吗?
不适用。那是 16 名资深开发者在平均 5 年历史的成熟开源代码库上的结果。新项目、新手、客服等场景的证据不同(Brynjolfsson 的 5179 人客服场景是 +14%)。任何把单一实验数字外推到「所有开发者」的转述都值得警惕——包括本文的引用方式。
Q5:个人使用者今天能做什么?
三条最小动作:重要产出前先自己写初稿再让 AI 改(而不是反过来);定期做「无 AI 练习」保持底层技能(Bastani 的 −17% 就是长期不用自己能力的对照组);对「AI 帮我省了时间」的感觉保持怀疑,用秒表而不是回忆来验证。
检索方法:检索窗口为 OpenAlex / Crossref 公开学术 API(截至 2026-09-24),检索式为各论断核心主张的英文关键词组合,命中后逐条经 DOI 逆向核对题录与引用数;纳入优先级为 RCT / 预注册实验 > 大样本调查 > 同行评议综述 > 概念论证,预印本单独分层并标注质疑状态。可能遗漏未收录的灰色文献与企业内部研究。
参考来源(分层标注)
同行评议论文(一手证据,共 11 篇)
- Bastani, H., Bastani, O., Sungu, A., et al. (2025). Generative AI without guardrails can harm learning: Evidence from high school mathematics. PNAS. DOI: 10.1073/pnas.2422633122
- Gerlich, M. (2025). AI Tools in Society: Impacts on Cognitive Offloading and the Future of Critical Thinking. Societies, 15(1). DOI: 10.3390/soc15010006
- Lee, H.-P., Sarkar, A., Tankelevitch, L., et al. (2025). The Impact of Generative AI on Critical Thinking… CHI 2025. DOI: 10.1145/3706598.3713778
- Fan, Y., Tang, L., Le, H., et al. (2024). Beware of metacognitive laziness… British Journal of Educational Technology. DOI: 10.1111/bjet.13544
- Kestin, G., et al. (2025). AI tutoring outperforms in-class active learning: an RCT… Scientific Reports. DOI: 10.1038/s41598-025-97652-6
- Dell'Acqua, F., et al. (2023/2025). Navigating the Jagged Technological Frontier… Organization Science. DOI: 10.1287/orsc.2025.21838
- Brynjolfsson, E., Li, D., Raymond, L. (2023). Generative AI at Work. NBER Working Paper 31161. DOI: 10.3386/w31161
- Perry, N., Srivastava, M., Kumar, D., Boneh, D. (2023). Do Users Write More Insecure Code with AI Assistants? ACM CCS 2023. DOI: 10.1145/3576915.3623157
- Clark, A. (2025). Extending Minds with Generative AI. Nature Communications. DOI: 10.1038/s41467-025-59906-9
- Generative AI tool use enhances academic achievement… (2025). Scientific Reports. DOI: 10.1038/s41598-025-01676-x
- Wilby, M. (2026). Clever But Not Wise: The Limits of AI and the Space of the Human. Human Affairs(经 Crossref 核验)
预印本(待复现或已有方法学质疑,共 6 篇)
- Kosmyna, N., et al. (2025). Your Brain on ChatGPT: Accumulation of Cognitive Debt… arXiv:2506.08872(54 人 EEG,受公开方法学评论质疑)
- METR (2025). Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity. arXiv:2507.09089
- Shojaee, P., et al. (2025). The Illusion of Thinking. DOI: 10.70777/si.v2i6.15919(受学界质疑)
- Bubeck, S., et al. (2023). Sparks of Artificial General Intelligence. arXiv:2303.12712
- Imagining and building wise machines: The centrality of AI metacognition. (2024). arXiv:2411.02478
- Comment on: Your Brain on ChatGPT… (2025). arXiv:2601.00856(对 Kosmyna 研究的方法学评论)
综述与概念文献(共 4 篇)
- AI-induced Deskilling in Medicine: A Mixed-Method Review. (2025). DOI: 10.1007/s10462-025-11352-1
- AI deskilling is a structural problem. (2025). AI & Society. DOI: 10.1007/s00146-025-02686-z
- Promises and challenges of generative AI for human learning. (2024). Nature Human Behaviour. DOI: 10.1038/s41562-024-02004-5
- Doshi, A., Hauser, O. (2024). Generative AI enhances individual creativity but reduces the collective diversity of novel content. Science Advances. DOI: 10.1126/sciadv.adn5290
被核验的评论原文
- Nedelcu, A. (2026-09-22). AI Has No Wisdom and Neither Will You. alexn.org(观点文,本文核验对象)

对本文有疑问、想交流技术方案或合作,扫码加我微信,备注来意通过更快。