JEV-as-a-Judge 科普:便宜的 AI 考官怎么干活,又靠不靠谱?
一句话结论:JEV 是一个「不写评语、只给分数」的便宜 AI 考官——它的核心价值不是更聪明,而是在简单任务上够用、在难题上会主动说「我没把握」,从而配合贵的模型把钱省下来。分级组合下保留顶级裁判约 99% 的准确率、费用降到约一半。
- 它是什么:TypeSafe JEV,一个专用「打分接口」——输入判断任务,直接输出结论和标签概率,不生成任何推理文字。定价 $0.042/百万输入 token、输出免费;实测每千次判断约 $0.044,同口径下顶级模型约 $12,相差约 277 倍。
- 核心机制是「分诊台」:论文发现 JEV 出错时它的置信度通常也低——于是设一道闸门:置信度 ≥0.9 的直接采纳(约 2/3 的任务),其余升级给顶级模型复核。τ=0.9 池化级联保留最强对比者 99.6% 的准确率、费用约 47%;跨任务汇总口径约 99%、费用约 57%。
- 真实成绩分层明显:偏好排序与最强裁判只差 1.25 分、有据事实核查甚至略好;但需要检查多步推导的难题落后 14.6 分(人工裁决后 −16.0),抵抗「写得漂亮的错误答案」时差距在 9–20 分区间。
- 无参考评分是所有裁判的边界:没有标准答案的主观文本评价,JEV 52.5%、顶级模型也只有 55%——全员接近随机,且平均置信度仍高达 0.90。这类任务别指望任何 AI 裁判。
- 保持警惕的五件事:省钱数字来自冻结阈值的离线模拟而非双流水线实测;论文未披露作者与 JEV 厂商的利益关系;面对「漂亮的错误答案」会自信地错;没有推理过程可审计;公开基准存在训练污染风险,阈值不能直接照搬。
1 · 为什么 AI 需要「考官」?
所有大语言模型的底层机制都是预测下一个词——它不是在「思考」,而是在按概率「猜」出最通顺的说法。这带来一个内生缺陷:它没法自己判断自己猜得对不对。它的训练目标是「说得像」,不是「说得对」;所以它可以用非常自信的语气说出完全错误的内容(幻觉),并且自己毫无察觉。
这也是为什么「让一个模型自己评自己」不靠谱:AI 生成回答(当运动员)和 AI 评判回答(当裁判)用的是同一套思维方式、同一种知识盲区。它的错是系统性的,不是偶然的。解决思路从来不是「发明一个不会错的模型」,而是在生成模型旁边加一层裁判——生成归生成,判断归判断。这套思路在行业里叫 LLM-as-a-Judge,已经是模型评测、回答筛选、训练数据质检的主流基础设施。
但传统 LLM 裁判有个成本死结:让 GPT 级别的模型当裁判,它要先写一大段「回答 A 在哪方面更好、但哪方面不足……」的分析,再给结论——而大模型按生成文字量计费,评语本身就是钱。评测规模一大(每天几万次内容审核、每次模型迭代的全量回归测试),裁判费就成了系统的主要开销之一。
2 · JEV 是什么:不写评语、只给分数
论文评测的主角叫 TypeSafe JEV——一家美国公司的托管服务(hosted service)。它的接口设计很特别:你给它自然语言指令和结构化输入,它不生成任何解释文字,直接返回一个判定结果和每个选项的概率。比如:
- 「选 A。确定度 0.97」← 大概率真有把握
- 「选 B。确定度 0.41」← 这句话的实际意思是「我基本在瞎猜」
为什么能做到这么便宜?因为按 token 计费的世界里,不生成理由就等于零输出成本。论文记录的定价与实测(JEV 1.13.0 版本):
| 指标 | JEV(决策式裁判) | GPT-6(最强对比裁判) |
|---|---|---|
| 每千次判断费用 | $0.044 | $12.182 |
| 计费方式 | $0.042/百万输入 token,输出免费 | 输入输出都计费 |
| 单次中位延迟 | 0.15 秒 | 1.9 秒 |
| 输出内容 | 结论 + 概率数字 | 推理过程 + 结论 |
| 成本倍数 | 基准(1 倍) | 约 277 倍 |
代价同样清楚:你不知道它为什么这么判;而且作为判别式架构,遇到真正烧脑的题它的准确率会明显下降——这正是后面分诊台设计的出发点。
3 · 分诊台机制:有把握就采纳,没把握就上报
这是论文标题的由来(Accept When Confident, Escalate When Unsure),也是全文最聪明的设计。逻辑像医院分诊台:护士先看一眼,感冒发烧直接处理;胸口疼、说不清病因的,转给专家。
支撑这个设计的核心发现是:JEV 判断错误的时候,它自己的置信度往往也低。置信度不是一个装饰性的数字,而是真实有效的「自我怀疑信号」。于是可以设一道闸门:
| JEV 的置信度 | 处理方式 | 任务占比(τ=0.9 池化) |
|---|---|---|
| ≥ 0.9 | ✅ 直接采纳 JEV 的判定 | 约 66% |
| < 0.9 | ⬆️ 升级给顶级模型复核 | 约 34% |
论文实测的级联效果(τ=0.9,跨任务池化):
- 准确率几乎不掉:级联得分 91.3%,对比全用 GPT-6 的 91.7%——保留 99.6%(配对差 −0.40 点,置信区间 [−1.21, 0.31],不显著);跨任务汇总的保守口径是保留约 99%。
- 成本省一半:级联总费用约为全用 GPT-6 的 47%(保守估算 44%),约 $6.3/千次判断。
- 置信度信号是真的:作为对照,随机挑 34% 的任务升级(而不是按置信度挑),只能达到 88.1%——按置信度路由比随机高 3.2 个百分点,证明这个信号携带真实信息。
一句话:它不是「更聪明的 AI」,而是更便宜的守门员——它的价值不在判得多准,而在知道自己什么时候不准。
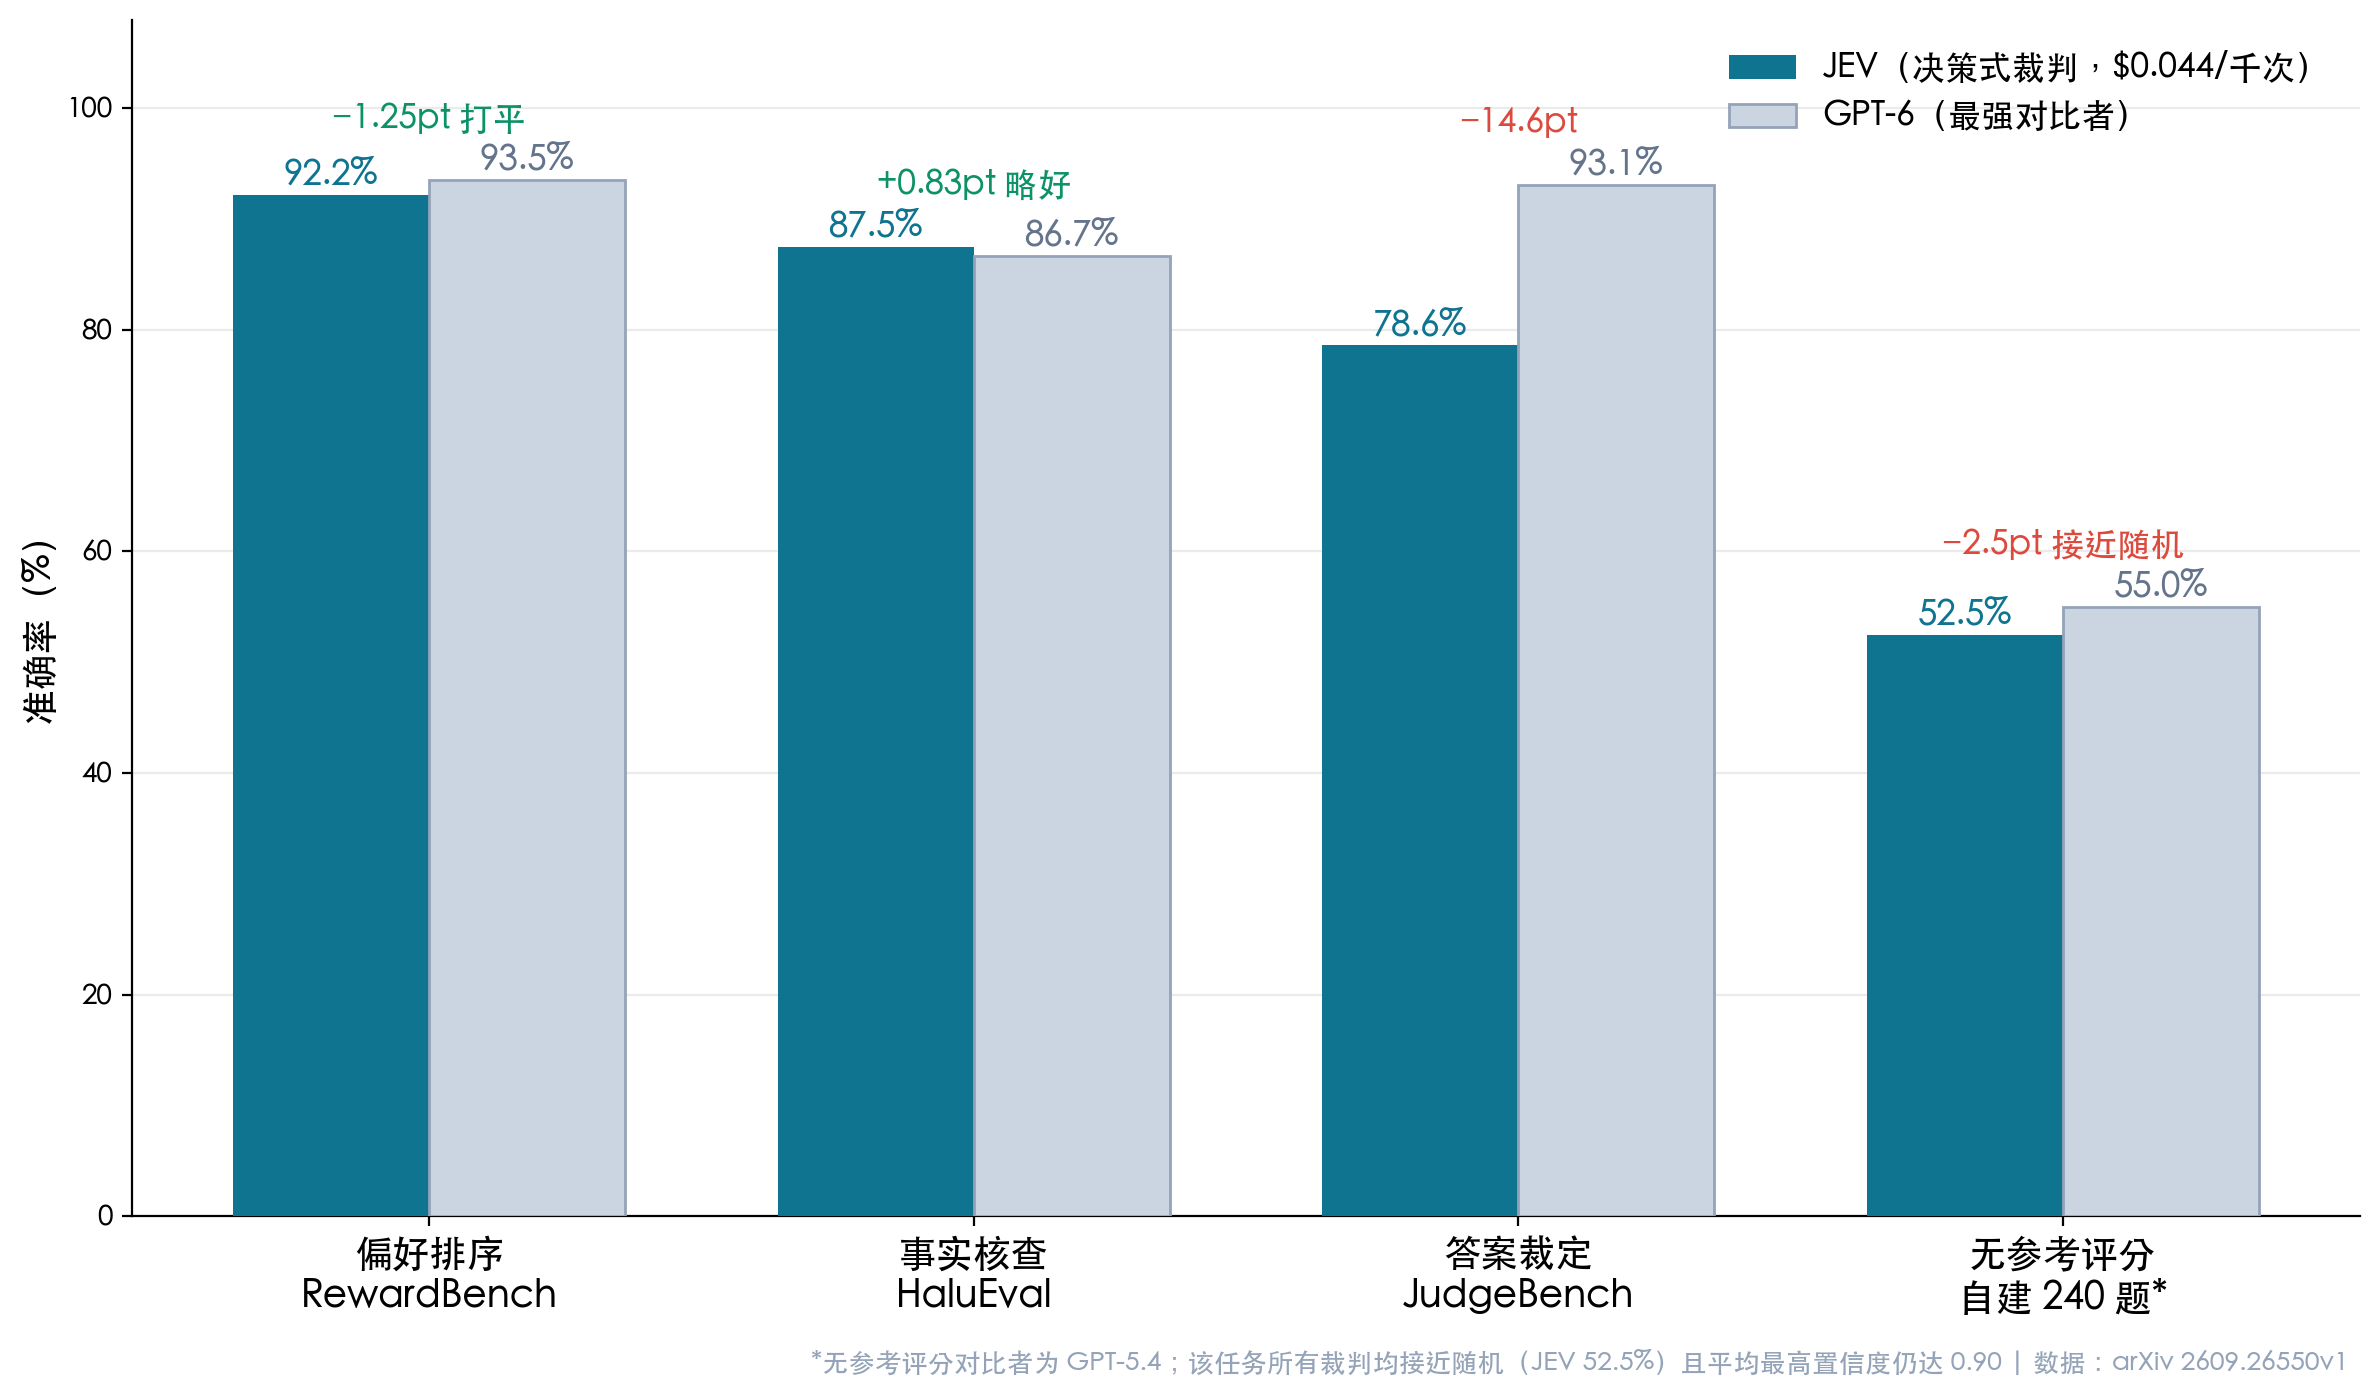
四类任务的真实成绩:简单任务两根柱子几乎齐平,需要多步推导的裁定任务明显拉开,无参考的主观评分则全员接近随机——且所有裁判此时依然高置信。数据:arXiv 2609.26550v1。
4 · 真实成绩:简单题打平,难题拉垮
论文把判断任务按所需的语义工作分了类,各类成绩差异非常大:
| 判断类型 | 典型例子 | JEV 表现 | 与最强裁判差距 |
|---|---|---|---|
| 偏好排序(RewardBench) | 「两段回答哪段更好?」 | 🟢 基本打平 | −1.25 分(92.2% vs 93.5%) |
| 有据事实核查(HaluEval) | 「这段说法与给出的证据一致吗?」 | 🟢 略好 | +0.83 分(87.5% vs 86.7%) |
| 答案裁定(JudgeBench) | 「这道多步推导题的最终答案对吗?」 | 🔴 明显落后 | −14.6 分(78.6% vs 93.1%) |
| 风格对抗陷阱(RM-Bench 变体) | 「写得漂亮但结论错误的回答」 | 🔴 大幅落后 | 差距在 9–20 分区间 |
| 无参考自由文本评分 | 「这份报告写得好不好?」 | ⚫ 全员接近随机 | JEV 52.5%,GPT-5.4 也只有 55.0% |
三个值得展开的细节:
- 难题上的差距是真的,不是标签噪声:JudgeBench 上两位裁判有 69 处分歧,盲评的人类裁决 57 次站在 GPT-6 一边、只有 1 次站在 JEV 一边——人工裁决后差距扩大到 −16.0 分。推理子集最惨(68.4% vs 95.9%)。
- 有据核查的优势部分来自标签噪声:HaluEval 上双方都「错」的 26 题里有 24 题的标注本身站不住脚;修正标签后 JEV 95.8%、GPT-6 98.3%。所以「JEV 略好」的正确读法是「打平」,而不是「JEV 更强」。
- 无参考评分是全体裁判的边界:没有标准答案的主观文本评价,三个受测裁判全部接近随机——而且平均最高置信度仍有 0.90–0.95。它们不仅错,还都自信地错。这类任务请直接交给人。
5 · 五个需要警惕的地方
论文正文其实相当诚实,但标题和摘要只讲了好看的那一半。以下五点,前三点论文有明确提示,后两点是阅读时需要额外注意的:
警惕 1:「省一半钱」是模拟出来的,不是上线跑出来的
级联结果是冻结阈值的事后离线模拟——拿已采集的判断数据推演「如果这样分层会怎样」,不是真的部署两条流水线跑生产流量。现实里你要先问便宜的裁判(0.15 秒)、再排队等贵的模型(1.9 秒),端到端等待时间可能反而更长;论文测的是单次调用延迟,没有实测级联的端到端时延。
警惕 2:「裁判」和「选手」可能是同一伙人
JEV 是 TypeSafe AI 的收费服务,论文对其做了大量正向评测;作者是卡内基梅隆大学的研究团队,但论文没有披露与该厂商的利益关系声明。这不代表数据有问题——对比组有 16 个裁判、且有盲评人类裁决兜底——但引用时应当意识到这是一份接近「产品深度评测」的研究,而非完全中立的第三方对比。
警惕 3:在「漂亮的错误答案」面前会自信地错
最危险的不是「不会」,而是「不会但以为自己会」。面对逻辑通顺但结论错误的回答(对抗性风格陷阱),JEV 与顶级模型的差距拉大到 9–20 分——它不仅判错,还可能高置信度地判错。把它放在合规审核、事实核查这类高后果场景时,这条是硬风险。
警惕 4:没有理由可查
普通 LLM 裁判会写「我为什么认为 A 比 B 好」,你可以追问和复核;JEV 只给分数和概率,没有推理过程可审计。在需要可解释性的场景(合规留痕、评分申诉、监管审查),这是结构性短板,不是调参能解决的。
警惕 5:公开基准可能「被见过」,阈值不能照搬
论文摘要明确提示:参考无关的文本评分与「阈值迁移失败(threshold transfer failure)」说明分级策略必须在本地数据上重新验证。公开基准(RewardBench、JudgeBench 等)存在被模型训练过程接触过的普遍风险——就像老师出题用了学生做过的练习册,分数可能虚高。论文的阈值(0.9)在它的任务集合上调出来,换一批任务就需要重新校准。
6 · 那「用国产轻量模型当裁判」行不行?
很多人的第一反应是:我用 DeepSeek、GLM 的轻量版当考官不就行了,何必关心 JEV?这里必须先说清楚一个事实:原论文没有测试任何国产模型——它对比的轻量基线是 GPT-4.1 mini、Gemini 3 Flash、Qwen3 系列等。下面的比较是架构层面的类比,不是实测结论:
| 维度 | JEV(专用裁判) | 通用轻量模型当裁判 |
|---|---|---|
| 设计目标 | 只做判断:判对错、排好坏 | 什么都能干:聊天、写作、也能打分 |
| 输出方式 | 结论 + 原生概率,无理由 | 先写推理再给结论(或口头报告概率) |
| 置信度来源 | 原生概率分布,校准较好,可直接用于路由 | 「嘴上说的」置信度,校准情况不确定 |
| 可解释性 | ❌ 无理由可审计 | ✅ 有推理过程可复核 |
| 难题表现 | 🔴 明显变差,会「自信地错」 | 🟢 推理能力更强,难题上更可靠 |
| 数据边界 | 海外服务,业务数据出境有合规约束 | 国产模型/私有化部署,数据可留在境内 |
论文的一个隐藏价值恰恰在这里:它证明的不是「JEV 多强」,而是「置信度驱动的分级裁判」这个架构是可行的。你完全可以用任何国产轻量模型扮演「第一级分诊」,把拿不准的升级给旗舰模型或人工——只是需要自己解决「轻量模型的置信度是否可信」这个 JEV 原生就解决的问题(比如用温度缩放或在本地验证集上重新校准阈值)。国内可落地的三条路:轻量大模型初筛 + 旗舰复核、云厂商的内容安全审核 API(偏合规方向)、开源模型私有化部署自建裁判接口。
7 · 什么时候用便宜裁判,什么时候必须升级?
把论文的边界映射成一张通用的决策表:
| 判断维度 | 可交给便宜裁判初筛 | 必须升级(人工/顶级模型) |
|---|---|---|
| 判断难度 | 简单、一眼能看出来 | 需要多步推导、专业判断 |
| 出错代价 | 错了影响不大,可以改 | 错了有合规/法律/医学风险 |
| 有无标准答案 | 有明确的对错标准 | 主观评价、没有标准答案 |
| 批量规模 | 量大、标准化 | 量小、定制化 |
| 「漂亮错误」风险 | 内容朴素、没有迷惑性 | 文案精美、容易被带偏 |
典型可用场景:两版文案哪个更通顺、AI 生成内容有没有明显事实错误、翻译是否通顺、表单要素是否齐全、批量初筛。必须人审的场景:涉及疗效宣称与合规红线的表述、多步医学/技术推理、没有标准答案的主观评价、以及一切「写得很漂亮但可能有问题」的高风险内容——论文已经证明,这正是便宜裁判输得最惨的地方。先从量大、对错明确、出错代价可控的场景试点,跑通了再扩展;高风险场景永远保留人工终审。
8 · 直接能用的三个提示词模板
不想懂架构和阈值?没关系——分级裁判的思路落到个人用户身上,就是「让 AI 按你的标准干活」。三个模板直接复制修改:
模板一:内容合规检查
请帮我审核下面这段内容,从这几个维度检查:
1. 有没有夸大宣传、疗效承诺的风险
2. 有没有不符合医疗器械广告规范的表述
3. 有没有事实错误或逻辑漏洞
4. 有没有「看起来很漂亮但其实有问题」的陷阱

请先给一个总体判断(安全/需修改/高风险),再列出具体问题和修改建议。

待审核内容:
【粘贴内容】
主动给出检查维度,AI 就不会只回「写得不错」这种废话。
模板二:两个方案对比打分
请对比下面两个方案,从这几个维度打分(1-10 分):
1. 专业度
2. 合规风险(分数越高越安全)
3. 表达清晰度
4. 针对性

请给出:每个维度的分数和理由、总分对比、
最终建议选哪个以及为什么。
如果你觉得都不太好,也请直说,并指出怎么改。
模板三:让 AI 帮你把流程固化成工具
帮我基于刚才这个任务,做一个可复用的模板/工作流。
下次我只要输入新内容,就能自动按同样的标准检查。
这就是「裁判模型」思路的个人版——你不需要懂什么是阈值、什么是级联;你只要说清楚「我要什么标准」,让 AI 帮你固化流程。
FAQ
Q1:JEV 比顶级模型便宜 277 倍,是不是可以直接全面替换?
不能。277 倍的差距来自「它不生成推理文字」,代价是复杂判断能力有限:需要多步推导的任务落后 14.6 分(人工裁决后 −16.0),对抗性陷阱题差距在 9–20 分。它的正确定位是海量简单判断的「第一道筛子」,与顶级模型组成分级流水线,而不是替代。
Q2:「保留 99% 准确率」这个数字怎么理解?
论文有两个口径:τ=0.9 池化级联在基准集合上得 91.3%,对比全用 GPT-6 的 91.7%,即保留 99.6%、费用约 47%;跨任务汇总的保守口径是保留约 99%、费用约 57%。两个口径都来自冻结阈值的离线模拟,不是生产环境实测。引用时建议注明口径。
Q3:这篇论文的结论可信吗?
方法学上比较扎实:16 个对比裁判、盲评人类裁决、预注册的冻结数据集、费用延迟实测。但三点保留:它是 2026-09-22 提交的预印本,未经同行评审;作者团队未披露与 JEV 厂商 TypeSafe AI 的利益关系;级联结果是模拟而非实测。方向值得重视,具体数字建议保持 10% 的怀疑。
Q4:国内能用 JEV 吗?
不能直接用——它是海外托管服务,且业务数据(产品资料、客户信息等)传境外有合规约束。但论文验证的「便宜裁判 + 置信度升级」架构完全可以在境内落地:国产轻量模型初筛、旗舰模型或人工复核。需要自己解决的两个问题是轻量模型的概率校准和阈值本地化。
Q5:个人用户能从这篇文章里拿走什么?
三个动作:让 AI 按你给定的维度清单审核内容(模板一);对比决策时强制打分并要求「不好就直说」(模板二);把重复出现的审核流程固化成可复用模板(模板三)。以及一个心态:对「没有标准答案的主观评价」,目前所有 AI 裁判都接近随机——这类判断请留给自己。
参考来源
核心论文(一手证据,预印本)
- Li, Y., Miao, Y., Krishnan, R., Padman, R. (2026). JEV-as-a-Judge: Accept When Confident, Escalate When Unsure. arXiv:2609.26550(2026-09-22 提交,cs.AI,未经同行评审)
论文使用的评测基准
- RewardBench(偏好排序基准): Lambert, N., et al. (2025). arXiv:2403.13787
- JudgeBench(客观正确性裁判基准): Tan, S., et al. (2025). arXiv:2410.12784
- HaluEval(有据幻觉检测): Li, J., et al. (2023). arXiv:2305.11747
- LLM-as-a-Judge 奠基工作: Zheng, L., et al. (2023). Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena. arXiv:2306.05685
- 级联降成本的先例: Chen, L., et al. (2024). FrugalGPT; Ong, I., et al. (2025). RouteLLM(见核心论文第 2 章引用)
被评测产品
- TypeSafe JEV(托管决策式裁判服务,JEV 1.13.0 定价口径);产品实现为专有闭源,本文数据均来自上述论文的独立测量

对本文有疑问、想交流技术方案或合作,扫码加我微信,备注来意通过更快。